结果在后,判断过程在前。FlowGrid 试图保存后者。
我做 FlowGrid,起点是一个很具体的工作现场:同一个项目里,我会同时使用好几个模型和 Agent。
Codex、ZCode、Hermes 各自能做的事不同。模型能力会变,成本有差异,订阅额度会耗尽,工具拿到的权限和运行环境也不同。我会根据当下的任务,把工作交给合适的 Agent,再换另一个继续推进。
工具一换,项目很容易失忆。
新的 Agent 能读文件,也能看一段对话。它仍然可能不知道这个项目为什么走到这里,哪些方向已经被否决,哪些结论只有初步证据,哪些边界经过反复讨论才确定。于是我又要解释一遍。解释少了,它会复活旧方案。解释多了,我要先给机器做项目入职。
这就是 FlowGrid 最早要解决的问题。
代码会留下结果,判断经常只留在对话里
我把工作粗略分成两类。
代码开发通常有相对明确的交付。代码、测试和运行结果会留下来,下一位接手者至少能检查当前产物。
策略、营销、内容、研究、运营和提案的情况不同。这些工作的大部分时间都用在定义问题、设定边界、推导取舍和修正判断上。我当时给出的估计是 80%。
最后交付的一份方案,往往只保留结论。中间最值钱的部分散落在聊天记录里:为什么放弃 A,为什么暂时接受 B,哪个事实已经确认,哪个判断还需要验证。换一个 Agent 后,成稿还在,项目形成判断的路径却断了。
结果可以被保存。形成结果的判断过程更容易在交接中断裂。
FlowGrid 想保存的正是这一层。它保存项目当前承认什么、怀疑什么、拒绝什么,以及下一步从哪里继续。
为什么先做成本地账本
早期方案选择很朴素:本地文件夹、CLI 和 Markdown。
项目目录是最高优先级事实源。账本跟着项目走,人可以打开检查,Agent 也可以读取。明文文件能够做 diff、版本管理和人工审查,也不会把项目记忆完全交给某个模型的黑箱记忆。
写入采用 patch-first。Agent 可以提出修改,正式判断仍要经过确认。这样做会增加一点操作,却能减少另一种更贵的成本:模型把推测写成事实,再由后面的 Agent 当真。
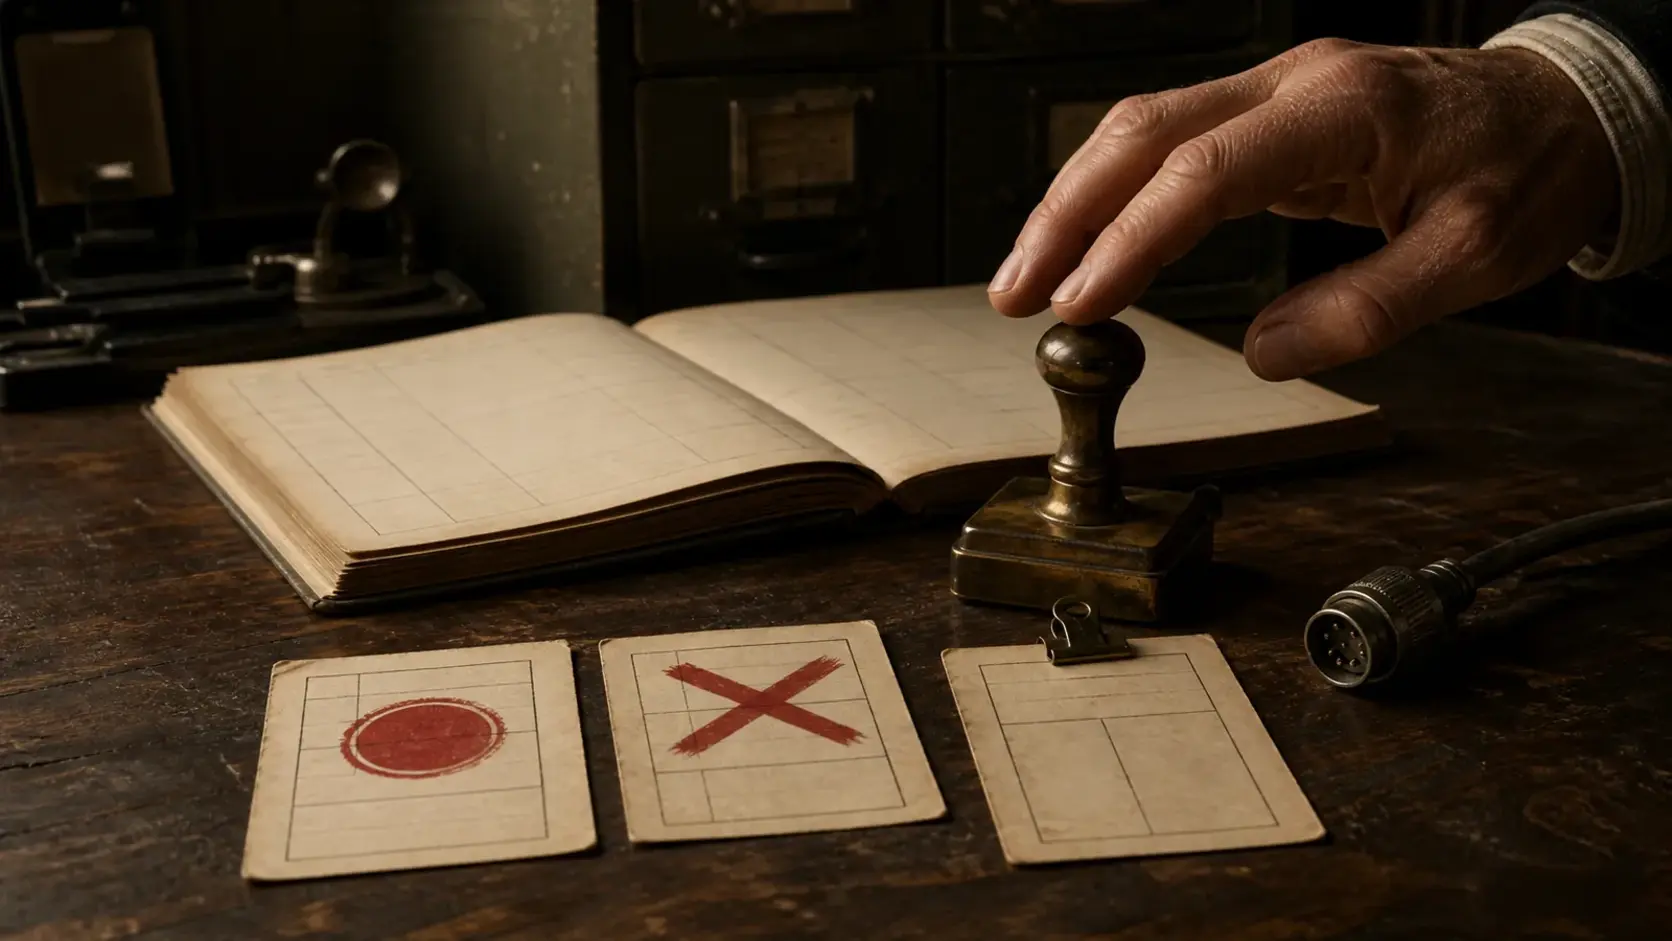
Agent 可以提出候选判断,正式账本仍然需要一次明确放行。
这些选择构成了 FlowGrid 的早期形态。它更像一套项目协议和一份可审计账本,当前没有承担模型路由、自动分配任务或统一管理多个 Agent 的职责。
创立动机和产品主张需要分开
多模型、多 Agent 共同推进一个项目,是我开始做 FlowGrid 的首要原因。
FlowGrid 当前的产品主张更窄:让项目状态可以续接,让判断保持连续。
这两个说法指向同一段经历,承担的任务不同。创立动机解释问题怎样出现。产品主张约束 FlowGrid 要交付什么。只要项目状态能被未来的我、下一次会话或另一个工具准确恢复,多 Agent 接力就会自然发生。FlowGrid 没有因此变成 Agent 调度器,也没有转向通用 Agent Memory 或团队协作平台。
这条边界很重要。模型、Agent 和运行环境还会继续变化。FlowGrid 要保住的是项目里的判断状态,不需要猜下一种工具会长什么样。
第八名把检索和治理分开了
代码与协议在 github.com/dlxeva/FlowGrid;问题背景见《代码项目有 Git,非代码项目靠什么让 AI 接力?》。
后来,我把其中一部分检索思路放进一条独立支线,做成 FlowGrid AML Retriever,参加 Agent Memory Leaderboard 首期公开开源方法评测。它与 FlowGrid Core 分仓、分版本,评测结论也分开记录。
这条支线拿到 43.98 分,在当时公开的 51 项系统提交中排第 8,与榜首相差 1.08 分。
名次验证了检索工程。系统完整保留原始消息,同时建立单条消息、滑动窗口和会话片段三类检索视图,再结合 FTS5、中文字符 n-gram、实体与数字日期精确匹配、邻接上下文、加权 RRF 和去重。检索返回原始证据,来源仍可回指。
分项结果给出了更有用的限制。按当时公开的 51 项提交重算,多跳与关系检索排第 8,上下文规则与工作流排第 4;记忆治理排第 42,个性化排第 40。检索做得好,无法自动获得可靠的时间状态、冲突裁决和个性化判断。
比赛结束后,我没有把 AML 支线并回 FlowGrid Core。两条线继续独立迭代。AML 负责快速试验检索方法,Core 只吸收经过消融和真实续接验证的检索能力。检索层负责找到证据,FlowGrid 账本负责确认状态和边界。
第八名是这条检索支线的评测结果,不能代替 FlowGrid Core 的产品验证。对我来说,它更像一次边界测试:过程证据可以搜得更准,项目仍然需要一套可审计的治理机制来判断哪些证据代表当前状态。
它还在验证什么
FlowGrid 已经跑过本地账本、CLI 闭环和多轮续接评估。当前产品仍处在 v0.3.0 / v0.4 validation 阶段。
已有评估显示,Context Pack 可以用更少的上下文保留项目边界,并且稳定优于完全无状态的接手方式。它还没有稳定胜过短而清晰的原始历史。真实长项目里的压缩价值、来源链稳定性和重复续接质量,仍需继续验证。
所以我现在能给出的结论有限:这个问题真实存在,协议和账本已经能运行,产品价值还在用真实项目校准。
下一步仍然是让不同 Agent 接手同一个长期项目,检查它们能否找到正确起点,保留已经确认的边界,并在证据不足时停下来。